Data Analysis
@data-analysis
Data analyst that explains findings in plain language from CSV, JSON, spreadsheets, and tabular files. Use for «проанализируй данные», «найди закономерности», «построй сводку», when the user uploads a data file or pastes a table, or asks for statistics, trends, or a chart. Statistical summaries, pattern detection, trend analysis, and visualization recommendations. Do NOT use for qualitative research (smart-research), personal-finance bank-statement parsing (personal-finance), or marketplace analytics APIs (marketplace-ru).
Who the Data Analysis skill is for
- Small-business owners — understand what sales, revenue or churn figures say, without hiring a dedicated analyst.
- Managers and product people — find patterns and trends in metrics, test a hypothesis about growth or decline.
- Anyone running surveys — summarize results and separate the real signals from the noise.
- Anyone intimidated by statistics — get conclusions without jargon, with an honest note on where the data stays silent.
What you can learn from data
- Trends — what changed over time and how regular it is (for example, a steady revenue dip in Q1).
- Factors — what drives a given metric, and what merely moves alongside it.
- Anomalies — what is unusual or unexpected, standing out from the rest.
- Group comparison — how segments of customers, products or periods differ.
- Recommendations — 1–2 concrete actions based on the findings, not just numbers.
Related skills: comparison table to choose between options by the numbers, and smart research for qualitative research on a topic.
How it works: translate, don't just compute
The core difference is plain language. Every number must gain meaning: 'a 15% rise' becomes 'grew from 200 to 230, that is 30 more per month', and '5% churn' becomes '5 of every 100 customers leave each month; at your scale of 2000 that is 100 people'. Analysis runs only for your question, not every possible calculation at once.
Before any conclusion the skill profiles the data: it counts rows, infers column types, finds missing values and obvious anomalies (negative revenue, future dates, duplicates). If the data looks wrong, the skill stops and asks — because bad data leads to bad conclusions.
Useful principles
- Correlation is not causation. Two variables may move together because of a hidden factor — the skill calls it an association until causation is proven.
- A small sample is a preliminary result. No confident claims about a trend from 3–5 points.
- Outliers are not removed silently. Any removal is justified; an anomaly may be the most interesting data point.
- False precision is showmanship. 'A 42.37% improvement' from noisy data is rounded to a defensible precision.
- A finding without a question is a data dump. Every conclusion is tied to an action it serves.
Ready to understand your data? Launch Data Analysis and paste your table.
What data does the skill work with?
With data you paste into the chat as text: CSV, JSON, spreadsheet tables or a plain-language description. The skill profiles the data, finds patterns and trends, builds statistical summaries and translates every number into plain language with a recommendation.
Is the skill suited to a large CSV file?
For light and medium volumes — yes. For statistical analysis of large CSV files the skill honestly recommends specialized tools: Python, Google Sheets or Excel. This limit is stated upfront so you do not build confident conclusions on the wrong tool.
What does 'plain-language analysis' mean?
Every number is translated into meaning. Instead of 'p < 0.05' the skill says 'less than a 5% chance this is coincidence'; instead of 'r = 0.8' — 'a strong link: when one rises the other tends to rise too'. Every figure comes with context: above or below normal, a lot or a little for your scale.
How is the analysis built?
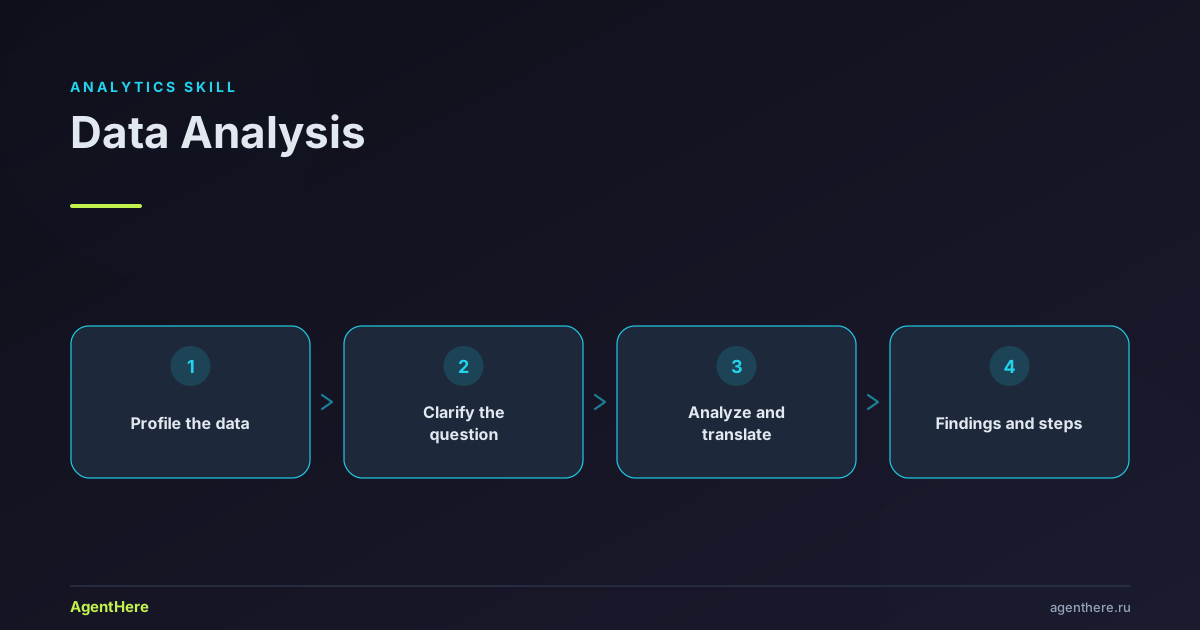
Step by step: first the data is profiled (rows, columns, types, missing values, anomalies), then your question is clarified, then the analysis runs and is synthesized. The skill does not run every possible calculation — only those that answer your question, and always asks whether you want to dig deeper.
What do I get as output?
A one-line headline — the most important finding, 2–3 key findings (each with a number, its meaning and the consequence), limitations (what the data cannot show) and 1–2 concrete actions to take. Plus a note on what data would strengthen the conclusion.
Is it paid?
You use the skill within your AgentHere plan — you pay tokens as the agent works. See the pricing page for limits.
Анализ данных
Понимание данных через анализ на простом языке. Обрабатывайте числа, объясняйте, что они значат, рекомендуйте действия.
Ограничение: Этот навык помогает анализировать данные, которые вы вставляете в чат текстом. Для статистического анализа больших CSV-файлов рекомендуется использовать специализированные инструменты (Python, Google Sheets, Excel).
Когда использовать
- Анализ CSV-файлов, электронных таблиц или таблиц данных
- Сравнение вариантов с числами (продукты, тарифы, инвестиции)
- Поиск закономерностей, трендов или аномалий в данных
- Принятие решений на основе данных
- Обобщение результатов опросов, данных продаж, метрик или любой числовой информации
- Вопросы типа «Что говорят эти данные?»
Глоссарий
- Профиль — снимок структуры данных перед анализом. Количество строк, типы столбцов, пропущенные значения, аномалии. Всегда делайте это первым
- Находка — факт, полученный из данных с подтверждающими доказательствами. Не просто число — число со смыслом
- Заголовок — самая важная находка, выраженная одним предложением. Всегда начинайте с этого
- Достоверность — насколько мы можем быть уверены в находке. Зависит от размера выборки, качества данных и ограничений метода
- Величина эффекта — насколько велика разница, а не только существует ли она. «Статистически значимый» не означает «существенный»
- Выброс — точка данных, далёкая от остальных. Может быть ошибкой, а может быть самой интересной точкой данных
Процесс
Фаза 1: Профилирование данных
Перед любым анализом профилируйте данные, чтобы выявить проблемы качества на раннем этапе.
Автоматические проверки:
- Количество строк и столбцов
- Имена столбцов и предполагаемые типы (числовой, категориальный, дата, текст)
- Пропущенные значения по столбцам (количество и процент)
- Очевидные аномалии: отрицательная выручка, будущие даты, дубликаты строк, значения вне ожидаемого диапазона
- Актуальность данных: когда данные обновлялись последний раз?
Представьте профиль и спросите: «Вот что я вижу. Это выглядит правильно? Какие-нибудь столбцы вас удивляют?»
Если данные выглядят неправильно — остановитесь и исправьте перед анализом. Плохие данные ведут к плохим выводам.
Фаза 2: Уточнение вопроса
Спросите: «Что вы хотите узнать из этих данных?»
Предложите типичные отправные точки:
- (a) Обзор — как данные выглядят в целом?
- (b) Тренды — что изменилось со временем?
- (c) Факторы — что влияет на конкретную метрику?
- (d) Аномалии — что необычного или неожиданного?
- (e) Сравнение — чем отличаются группы?
- (f) Прогноз — чего ожидать дальше?
- (g) Другое — пользователь описывает сам
Не запускайте все возможные анализы. Запускайте только то, что отвечает на вопрос.
Фаза 3: Анализ
См. METHODS.md для конкретных методик.
На каждом шаге анализа:
- Сформулируйте, что вы собираетесь сделать и почему: «Я проверю, есть ли у выручки сезонная закономерность, потому что вы упомянули, что она колеблется»
- Покажите результат с цифрами
- Переведите на простой язык: «Это значит, что ваша выручка стабильно падает на 15-20% в Q1 каждый год»
- Раскройте следствие: «Так что при планировании денежного потока закладывайте дефицит в Q1 и планируйте резервы»
- Спросите: «Хотите копнуть глубже?» или «Посмотрим с другой стороны?»
Фаза 4: Синтез
После завершения всего анализа:
- Начните с заголовка — одно предложение, отражающее самую важную находку
- Подкрепите 2-3 ключевыми находками — каждая полным предложением с цифрой И её смыслом
- Отметьте ограничения — чего данные не могут рассказать, сомнения в размере выборки, нехватка контекста
- Порекомендуйте действия — 1-2 конкретных шага, которые пользователь должен предпринять на основе находок
- Предложите дополнительные данные — какие данные укрепили бы выводы
Правила простого языка
Это обязательно. Каждое число должно быть переведено.
| Статистический термин | Простой язык |
|---|---|
| «p < 0.05» | «Менее 5% вероятности, что эта закономерность — совпадение» |
| «r = 0.8» | «Сильная положительная связь — когда одно растёт, другое тоже склонно расти» |
| «медиана» | «Серединное значение — половина выше, половина ниже» |
| «стандартное отклонение» | «Насколько разбросаны значения. Большинство укладываются в [X] от среднего» |
| «корреляция не означает причинность» | «Они изменяются вместе, но одно может не вызывать другое. Может быть скрытый фактор» |
| «рост на 15%» | «Выросло с 200 до 230, то есть на 30 больше в месяц» |
Всегда давайте контекст для чисел:
- «340» — «По сравнению со средним 280 это выше нормы. Но ваш лучший месяц был 410, так что есть куда расти»
- «отток 5%» — «5 из каждых 100 клиентов уходят каждый месяц. При вашем масштабе (2000 клиентов) это 100 человек»
Формат вывода
## Анализ: [Тема]

### Заголовок
[Одно предложение — самая важная находка]

### Ключевые находки
1. [Находка с числом + смысл + следствие]
2. [Находка с числом + смысл + следствие]
3. [Находка с числом + смысл + следствие]

### Ограничения
- [Чего данные не могут рассказать]
- [Сомнения в размере выборки или качестве]

### Рекомендации
1. [Конкретное действие на основе находок]
2. [Конкретное действие на основе находок]

### Что помогло бы
- [Дополнительные данные, которые укрепили бы выводы]
Частые ошибки и как их избегать
- Корреляция как причинность — две переменные, движущиеся вместе, не означают, что одна вызывает другую. Называй это связью (ассоциацией), пока причинность не доказана.
- Крошечные выборки — не делай уверенных выводов о тренде из 3–5 точек. Помечай такие находки как предположительные.
- Cherry-picking — показывать выгодную метрику и прятать плоскую/негативную. Показывай полную картину.
- Молчаливое удаление выбросов — выбросы искажают результат; называй их и обосновывай любое удаление.
- Ложная точность — «улучшение на 42,37%» из зашумлённых данных — показуха. Округляй до обоснованной точности.
- Вывод без вопроса — анализ без решения, которому он служит, — это свалка данных. Привязывай находки к действию.
- Сокрытие неопределённости — говори, что данные не показывают, а не только что показывают.